大阪リハビリテーション専門学校理学療法学科 統計学2026
授業について
教科書
理学療法研究法(医歯薬出版株式会社)https://www.ishiyaku.co.jp/search/details.aspx?bookcode=267350
授業メニュー
第1回~第2回までが臨床現場含め日常的に用いる指標の話第3回~第4回までが臨床研究で必要とされる指標の話
第5回~第8回までが研究上必要とされる指標の検証の話
第1回 統計解析(1)記述統計(度数,代表値)
第2回 統計解析(2)記述統計(グラフ,散布度,相関係数)
第3回 研究法(1)量的研究(観察研究(1))
第4回 研究法(2)量的研究(観察研究(2)介入研究),ROC解析
第5回 統計解析(3)推測統計(推定)
第6回 統計解析(4)推測統計(検定(1))
第7回 統計解析(5)推測統計(検定(2))
第8回 統計解析(6)推測統計(検定(3))
第1回 統計解析(1)記述統計(度数,代表値)
到達目標1-1測定尺度について説明できる
1-2度数分布表を作成することができる
1-3よく使われる指標である代表値を状況に応じて算出することができる
教科書P80-81,P100-102
世の中の事象を研究するにはそれらをデータとして取り扱わない限り成立しない
データと情報と知識
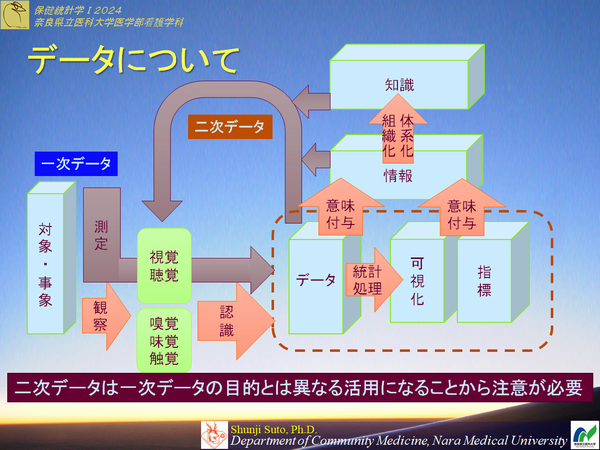
データ
ノイズとして認識しなかった事柄の記録発生するデータは受診特性に依存する.
一次データと二次データに分けられる
一次・・・対象からダイレクトに取得
二次・・・既に記録されたもの。まとめられたもの
情報
データに意味を付与したもの情報化にあたって受信者の特性に依存する.
知識
情報を体系化したもの。受信者の知性に依存する.
その時点での受信者の知識によるところが大きい
データには様々なものがあるが,それぞれの性質により大きく4つの分類(4つの尺度)と2つの大まかな分類(量と質)に整理されている
尺度
食事の際,質(みずみずしい,ふっくら)と量(おかわり)の二つの軸から満足しているそれらをもう少し細かく分類すると4つの尺度となる
4つの尺度
世の中のデータを4つの種類で説明できる1名義尺度(質的データ)
2順序尺度(質的データ)
3間隔尺度(量的データ)
4比尺度(比例)(比率)(量的データ)
1,2を質的変量(定性的)ともいう
3,4を量的変量(定量的)ともいう
性質としては上位互換性があり
4>3>2>1
間隔尺度と比尺度との見分け方
データ自身が負の値をとることが想定されるものは間隔尺度(引き算などで便宜上マイナスになるものはデータ自身によるものではない)天気予報での摂氏温度(℃)の話をどのようにされているのか(過去に一回だけビックリしたことがあるけど)
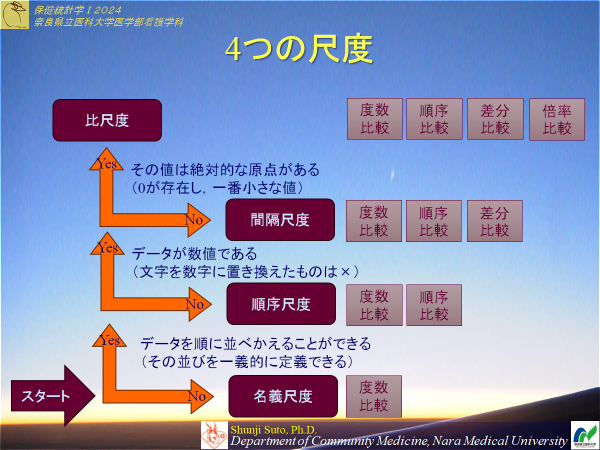
奈良県立医科大学 保健統計学I2024(医学部看護学科)より
例題1-1
以下の文章中の下線部の尺度を示せ折角の(1)日曜日【月曜日,火曜日】,天気も(2)晴【曇,雨】なので車に乗って(3)奈良駅【郡山駅,畝傍駅】までドライブ.
昼食はハンバーガーチェーン店でチーズバーガーとポテトを購入,ドリンクは(4)Lサイズ【Mサイズ,Sサイズ】を選ぶ
昼食後車を走らせるがガソリンが少ないので(5)35リットル【20リットル,5リットル】ほど給油.
無事目的地に到着し駐車場から外に出るとなにやら(6)少し寒い【温かい,熱い】,確かに気温を見ると(7)12℃【10℃,8℃】と先程よりも低い
なので上着を買って帰ることにした.丁度バーゲンセールをやっている.値段は(8)3980円【2980円1980円】,(9)凄く良い【まぁまぁ良い,少し残念な】ものを買うことが出来ました.
(10)つぎも【こんども,この先も】良いものを買えたらいいな.
<資料>
電車の先発・次発、関東では「こんど・つぎ」表記って本当? 定番の地域ネタ、真面目に検証してみた(Jタウンネット)
https://j-town.net/2019/05/04278986.html?p=all
「今度」という言葉について(Yahoo知恵袋)
https://detail.chiebukuro.yahoo.co.jp/qa/question_detail/q1218803532
度数
どのようなデータでも名義尺度の性質を有している.名義尺度は数を数える(度数)ことでのみ,量的な取り扱いが可能になる
例題1-2
以下の40名の血液型データについて度数を求めよ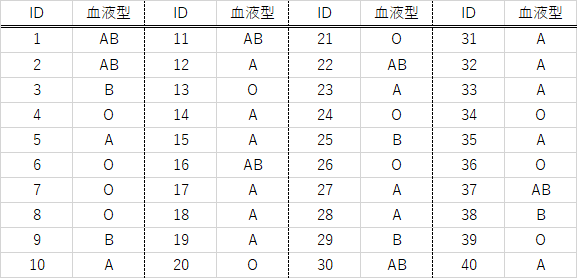
度数分布表
度数は表にすることで,全体の状況が把握しやすくなる度数分布表はそれぞれのデータの度数(出現頻度)をまとめたもの
名義尺度の時は多い順(お作法として。但しその他を出すなら一番最後)
順序尺度以降であれば順(名義尺度でも比較のためにお作法を破ることはある)
度数 ・・・出現頻度
相対度数・・・総出現頻度を1(100%)としたときのそのぞれの度数のしめる割合
累積度数・・・上位で出現していた度数もあわせた度数
累積相対度数・・・累積度数の相対度数
| (名称) | 度数 | 相対度数 | 累積度数 | 累積相対度数 |
|---|---|---|---|---|
| 計 | 1.00 | ----- | ----- |
例題1-3
例題1-2で求めた血液型別度数より度数分布表を作成せよ量的変量の度数分布表の注意点
例えば身長を0.1cm単位で測定して度数分布表を作成しようとしたとき,全て度数は1で全体の状況の把握が出来ないケースがあるその場合ある程度の区間を設けて度数を求める
量的変数の場合はその数値だけで度数を積み上げようにもなかなか上手くいかない場合がある.
|
「A~B」は「A以上B未満」と読む格好がスタンダードと思っていますが,分野などによって違うようです 「A以上B以下」のようにどちらの階級にも属してしまう可能性のある設定はしないように. |
| 階級 | 階級値 | 度数 | 相対度数 | 累積度数 | 累積相対度数 |
|---|---|---|---|---|---|
| 130~140 | 135 | ||||
| 140~150 | 145 | ||||
| 150~160 | 155 | ||||
| 160~170 | 165 | ||||
| 170~180 | 175 | ||||
| 計 |
結局のところ作成する目的と集計する方の知識によるところがある.
例題1-4
あるクラスの生徒の身長を計測したところ以下のような結果が得られた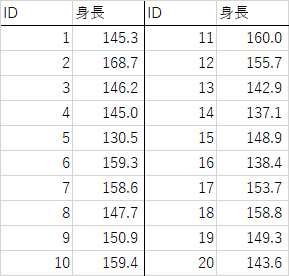
度数分布表を作成せよ
理解度チェック問題
マラソン選手のタイムと順位はそれぞれ何尺度に相当するか20260925 ocrptstat2026-01ここまで
代表値
量的変量の統計量になりますが,量的変量は質的変量の性質も持っているので,その性質を利用した統計量もあります.平均
算術平均
1/n・Σxiパレートの法則(80-20の法則)
代表値なのに実在しない場合がある → 集団の指標(重心)であって、事象を代表する値そのものを示しているとは限らない

<参考>
2024(令和6)年 国民生活基礎調査の概況(厚生労働省)
https://www.mhlw.go.jp/toukei/saikin/hw/k-tyosa/k-tyosa24/index.html
加重平均
重みづけ平均例えば ミニテストと期末試験の平均をとる → そのままの平均で良いの?
度数分布表を用いた平均もこの方法・・・Σ(階級値×階級の度数)/n
例題1-5)
例題1-4)の生徒の身長の計測結果よりa)この集団の算術平均を求めよ
b)例題1-4)で求めた度数分布表を用いて集団の平均値を概算せよ
中央値
(別名第2四分位数)量的変量を順序尺度の性質で処理した代表値
順番に並べたとき真ん中の順位にきた個体の値
個体数が偶数の時は真ん中2つの数値の平均値
例題1-6)
例題1-4)の生徒の身長の計測結果より中央値を求めよ最頻値
多数決の世界量的変量を名義尺度の性質で処理した代表値
階級毎に度数をカウント
一番多いところの階級値
一位が同点の時は併記
例題1-7)
例題1-4)の生徒の身長の計測結果より最頻値を求めよ平均値と中央値の違い

平均値(14.55)
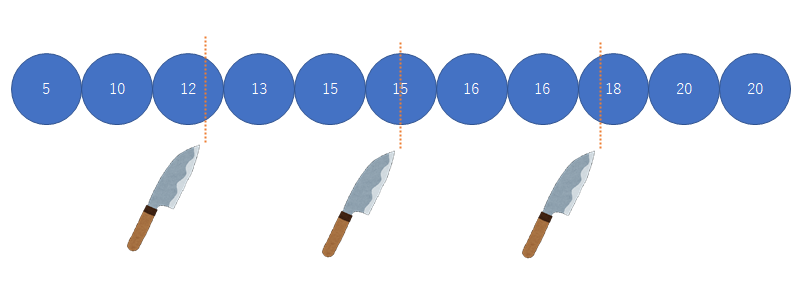
中央値(15)
データの分布に依存する(パラメトリック)=平均値と
データの分布に依存しない(ノンパラメトリック)=中央値,最頻値
の関係について整理しておいてください.
第2回 統計解析(2)記述統計(グラフ,散布度,相関係数)
到達目標2-1目的に応じた適切なグラフを用いることができる
2-2よく使われる指標である散布度を状況に応じて算出することができる
2-3よく使われる指標である相関係数の考え方と値の評価が出来る
教科書P51-52,P102-105,P118-122,P139-153
グラフ
度数を直接示すものだけではなく,割合を示すものや,時間変化を示すものまである度数分布図
度数分布表を棒グラフにしたもの質的変数
縦棒グラフ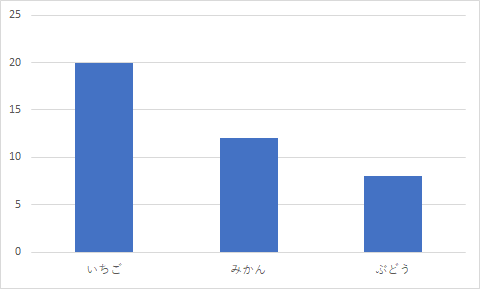
量的変数
ヒストグラム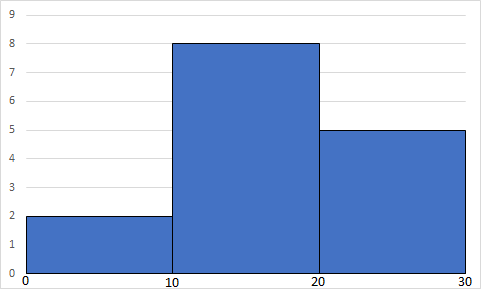
棒の間隔が無いのは値が連続している状態であるが故
普通の棒グラフは棒の長さが度数を示すが,ヒストグラムは棒の面積が度数を示す
| 「階級の幅を等しくすること」と説明している場合があるが,それは幅が変わると高さが変わる故で,実際にはそのような区間設定はよくある |
|
ヒストグラムーなるほど統計学園(総務省統計局) https://www.stat.go.jp/naruhodo/4_graph/shokyu/histogram.html |
箱ひげ図
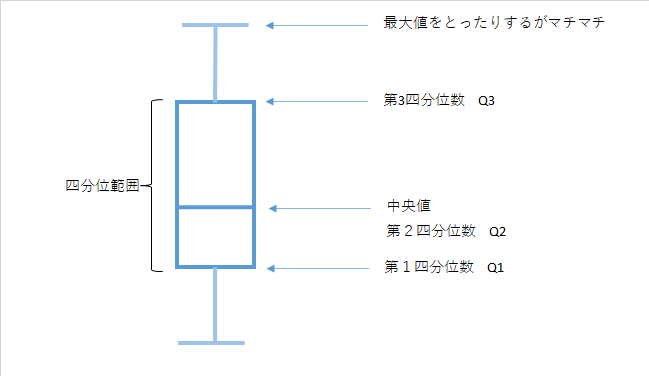
箱ひげ図は度数の分布の状況を四分位数を用いて示す
エラーバーグラフ
箱ひげ図と似ているが,平均値を点で示し量的な散布度(標準偏差(SD),標準誤差(SE),2SD,2SE,95%信頼区間(95%CI))を箱ひげ図と同様にヒゲ(=エラーバー)で示している箱ひげ図よりもエラーバーグラフにお目にかかることが多いかもしれない
平均値は点で示したり線で示したり,エラーバーの末端は線で止まるケースもあれば箱ひげ図にように線を引くケースもあります
円グラフ
・個別の度数の全体に対する割合を円の角度で示したもの・項目間の比較において特定の項目同士の比較には効果的だが,多項目の比較になるとわかりにくい


・度数の表現には適さない
帯グラフ
棒グラフ(積み上げ)の高さを揃えて割合を比較したもの
円グラフと比べて項目が多くても把握しやすい
折れ線グラフ
変化の傾向をとらえるのに有効東京都年齢階級別新型コロナウイルスの新規陽性患者数(7日移動平均).と累積陽性患者数のグラフ(ともに人口10万対)3月24日~9月19日. pic.twitter.com/vYT1UnSVck
— めどぶぶ (@medbb) September 19, 2020
平滑化
折れ線グラフで傾向を見るには傾向以外の要因を取り除かないとわかりにくい以下は一日の歩数をグラフで示したもの(ダミーデータ) 7点平均をとることで,上昇している傾向が把握できる

レーダー図
複数の項目データを二次元にマッピングすることでパターンを作成し,類型化することが出来る
散布図
二つのデータの関連性を示す. 2つの量的変数の関係を可視化することができる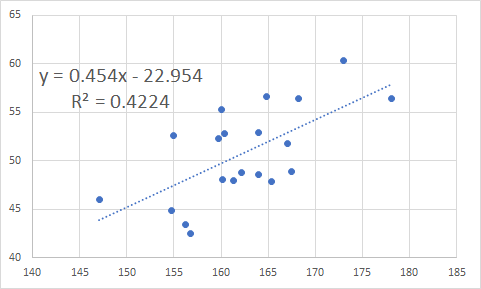
三次元グラフ
二次元空間に三次元のものを書こうとすると歪んで当然
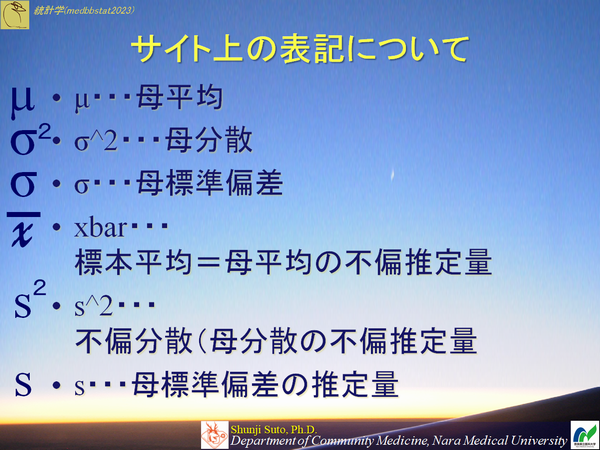
記号について
統計は記号の取り扱いで混乱するのでここで整理しておきます.分かりやすさを優先して整理したので,皆さんの使っている教科書などの表記は<参考>の論文を確認し読み替えください
μ・・・集団全体(母集団)の算術平均=母平均
σ^2・・・集団全体(母集団)の分散=母分散
σ・・・集団全体(母集団)の標準偏差=母標準偏差
xbar・・・集団の一部(標本)の算術平均=標本平均=母平均の不偏推定量
s^2・・・集団の一部(標本)より求めた母集団の分散の推定量=不偏分散(母分散の不偏推定量)
s・・・集団の一部(標本)より求めた不偏分散よりもとめた標準偏差=母標準偏差の推定量
参考
統計学テキストの「分散」の表記に関する調査(札幌学院大学総合研究所紀要 巻 1, p. 1-10, 発行日 2014-03-31)https://sgul.repo.nii.ac.jp/records/1807
散布度
dispersion範囲
ある値~ある値までの広さ範囲
RangeR=最大値-最小値
特徴
外れ値もひらう
算出が用意
四分位範囲
小さい順(昇順)に並べて集団を4分割分割する所の値を小さい方から第1四分位数(Q1),第2四分位数(Q2)=中央値,第3四分位数(Q3) 四分位範囲IQR(interquartile range)=Q3-Q1
四分位数の話
四分位数は出し方が何種類かあります.近年は高校で教育されていますがその方法も従来のものと異なるので細かい計算をするのはやめておきますパーセンタイルの話
第1四分位数は25%タイル値,第2四分位数は50%タイル値,第3四分位数は75%タイル値のことです.混乱しがちなのは第一四分位数が小さい方から数えてなのに,大きい方から数える人がいます
その時はパーセンタイルで整理したほうが良いかもしれません(100%=最大値)というのは納得できると思うので上から75%=第3四分位数
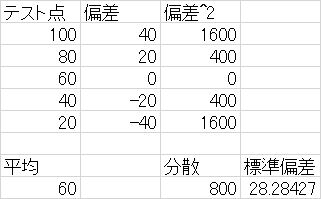
偏差
Deviationある基準とする値からのズレ
それぞれのズレの平均を求めたら良いのだろう・・・
20261002 ocrptstat2026-02ここまで
分散
varianceexcel関数はVAR
偏差を平方(二乗)したものの平均
ここでは記号をσ^2とする. Σ(Xi-Xbar)^2/n
何故平方するの?
どうしても偏差の平均を求めることが出来ないので
標準偏差
Standard Deviation記号はσ
σ=√(σ^2)
例題2-1)
以下の表について| ID | テストの点 |
|---|---|
| 1 | 40 |
| 2 | 40 |
| 3 | 80 |
| 4 | 60 |
| 5 | 30 |
b)この集団の標準偏差を求めよ
c)この集団の範囲を求めよ
d)この集団の中央値を求めよ
e)それぞれの偏差値を求めよ(偏差値は平均点が50 1標準偏差分良い点であれば+10で60になる)
相関
correlative二つの量的変量のデータに関係があるのかの指標
相関関係がある・・・関連がある
相関関係が無い・・・関連がない
他方の影響を受けるか受けないか
因果
cause and effect原因と結果
因果関係がある・・・影響がある
因果関係が無い・・・影響がない
交絡因子について
普通は関連がある(相関がある)=影響を及ぼす関係(因果関係がある)と考える(考えたくなる)例
たばこを吸う-肺がん・・・・相関関係○
コーヒーを飲む-肺がん・・・相関関係○
コーヒーと肺がんの相関関係に割り込んでいる(どちらとも相関関係がある)状態=交絡
割り込んでいるそれ=交絡因子・・・たばこ
コーヒーと肺がんに因果関係が無いとしたならその関係は疑似相関
散布図(再掲)
X軸とY軸に一つの対象に与えられるそれぞれの値をプロット(例:身長と体重)とりあえず図にすると関係が直感的にわかる(場合がある)
相関係数
-1から1までの値をとるXが増加すればYも増加する・・・1
Xが増加すればYは減少する・・・-1
Xが増加しようが減少しようがYは関係ない・・・0
X軸で見たときのバラツキ具合とY軸で見たときのバラツキ具合を元に計算してる
バラツキ=散布度・・・分散・・・偏差の二乗の平均
共分散=ある対象のX軸の偏差とY軸の偏差を乗じたものがベース
| Xの偏差 | Yの偏差 | 乗じた結果 |
|---|---|---|
| + | + | + |
| + | - | - |
| - | + | - |
| - | - | + |
共分散はX軸Y軸のバラツキ具合が混ざっているのでそのままの数字だと解釈しにくい→XとYの標準偏差で除する(正規化)→相関係数
相関係数の目安
| -1.0 | ⇔ | -0.7 | ⇔ | -0.4 | ⇔ | 0 | ⇔ | 0.4 | ⇔ | 0.7 | ⇔ | 1.0 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 強い相関 | 中程度の相関 | 弱い相関 | 無相関 | 弱い相関 | 中程度の相関 | 強い相関 | ||||||
| 負の相関 | 正の相関 |
平均値で相関係数を求める際にはご注意を

X軸が最高気温(ある月の最高気温の平均),Y軸がアイスクリームの支出額になります.左上がオリジナル下におりていくと気温で平均を取った値で作成したものです
オリジナルデータの相関係数から平均を取るたびに大きくなっています
(0.899→0.914→0.938)
以下のデータを用いました
<出典>
暑い日にアイスクリームは売れる?~関係をみるグラフ~(宇宙統計ステーションNARUHODO 総務省統計局)
https://www.stat.go.jp/naruhodokids/graph/is-e5-static.html
回帰直線
X軸の値とY軸の値を数式(y=aX+b)で示す直線を引いたときにそれぞれの点からの差(残差)の2乗して足したもの(平方和)が最も小さい時の数式が回帰直線
単回帰分析
回帰係数・・・Y=aX+bのa決定係数・・・1に近いほど良好なモデル
決定係数
相関係数を二乗したもの数式によって説明できる割合を示す。(寄与率とも)
高ければ高いほど数式で説明出来る
傾きの推定
傾きの推定値が0を含まないと,その項の変数(独立変数)はy(従属変数)にどのような影響を与えているのか説明できる重回帰分析
モデル式を作りどのような変数が影響を与えているのか分析重回帰式
Y=a+b1X1+b2x2+・・・ 目的変数・・・Y説明変数・・・Xi
偏回帰係数・・・bi
標準偏回帰係数 β* 目的変数と説明変数の関係を標準化したときの偏回帰係数・・・
目的変数は量的
説明変数は量的でも質的(0,1)でも
理解度チェック問題
10点満点のテストを5人の学生に解いてもらった.最低点は4点,最高点は10点 最頻値は10点 平均値は7点である.標準偏差を求めよ
第3回 研究法(1)量的研究(観察研究(1))
到達目標3-1観察研究の方法について説明できる
3-2リスク比が相対的な危険度を示すことを説明できる
教科書P1,P13-18
研究とは
【説明できない現象】を説明できるようにすること世の中には解明されていないものが多い
医療においても例外なく,様々な事柄が明らかにされてきた
研究で得られた新たな知見がもたらすもの
何故発症するのかわからない・・・→研究により明らかになる(例)胃潰瘍
胃潰瘍の原因は?・・・ストレスストレスだけで胃潰瘍の発生メカニズムを説明できない・・・
研究により他の発生メカニズムでも説明できるようになる
<参考>ストレス【クイズで学ぶ胃のメカニズム】(Eisai)
https://www.eisai.jp/articles/gastrointestinal_trivia/quiz02
消化性潰瘍(日本薬学会)
https://www.pharm.or.jp/words/word00836.html
臨床と研究

臨床・・・医療を実践している場
臨床研究・・・臨床の場で生じた疑問や仮説についての探究
倫理
臨床倫理と研究倫理の違いについて整理臨床・・・対象者の生活向上を
研究・・・新たな学術的知見の獲得に向けて
どちらも対象者への同意が必要
因果関係を明らかにする
臨床を中心とした研究となると因果関係(原因と結果)の話が主題リスクの評価・・・どの程度原因によって危険になったのか
この教科書ではリスク比を相対危険としている.
リスクの評価指標の総称を「相対危険」や「相対危険度」と読むケースが多いように思う
本授業では相対危険度の一つにリスク比があるとする
もう一つはオッズ比
相対危険度
暴露の有無によりどの程度危険度が影響を受けるのかを示す指標リスク
危険な事象(失敗とか)が起こる確率(リスクをとる・・・危険な事象の起こる確率が高い状況を承知で取り組む)
どの程度危険な事象が起こるのか
例題3-1
利き手で玉入れをしたところ10球中9回成功した.失敗するリスクは?例題3-2
利き手ではない方で玉入れをしたところ10球中6回成功した.失敗するリスクは?例題3-3
利き手ではない方で玉入れをすることで失敗するリスクは利き手で行う場合と比較して何倍になるか?リスク比

Risk Ratio(RR)
曝露(介入)の有る時と無の時の危険を示す指標の比
危険を示す指標には罹患率やら有病率やら死亡率やら
例題3-4
利き手で玉入れする被験者を100名,利き手じゃない手で玉入れする被験者を100名用意し離れたカゴに玉入れしてもらったところ以下の結果になった利き手じゃないことによる相対危険度のリスク比を算出せよ
| 地面 | カゴ | 計 | |
|---|---|---|---|
| じゃない | 10 | 90 | 100 |
| 利き手 | 5 | 95 | 100 |
| 計 | 15 | 185 | 200 |
説明用データ
| 罹患有 | 罹患無 | 計 | |
|---|---|---|---|
| 曝露有 | A | B | A+B |
| 曝露無 | C | D | C+D |
| 計 | A+C | B+D |
曝露有群の罹患リスク=A/(A+B)
非曝露無群の罹患リスク=C/(C+D)
リスク比=A/(A+B)/C/(C+D)
もし、罹患頻度が低ければA+B≒B C+D≒D
リスク比≒A/B/C/D=AD/BC
観察研究
生態学的研究
1)ある時点での集団と異なる集団の要因と状態を比較2)集団で時点を変えて状態を比較
記述疫学の延長線・・・「仮説の設定」
あくまでも集団単位
記述疫学(一般社団法人日本疫学会)
https://jeaweb.jp/glossary/glossary002.html横断研究
ある時点における個人単位での状態と要因について一度に調査累積有病率など
因果関係を明らかにできない(原因(曝露)があって結果になる)
コホート研究
コホート・・・追跡する集団結果より原因が先行する・・・原因(曝露)に基づく集団・・・曝露情報の妥当性が高い
・利点(時間の流れに沿った解釈が出来る 稀な曝露に対応できる)
・欠点(追跡にコストがかかる 稀な疾患には対応困難)
相対危険度
リスク比を求めることが出来るリスク比(振り返り)
Risk Ratio(RR)曝露(介入)の有る時と無の時の危険を示す指標の比
危険を示す指標には罹患率やら有病率やら死亡率やら
A~D:疾病発生頻度
曝露有群の発症リスク=A/(A+B)
曝露無群の発症リスク=C/(C+D)
リスク比=A/(A+B)/C/(C+D)
もし、発生頻度が低ければA+B≒B C+D≒D
リスク比≒A/B/C/D=AD/BC
例題3-5
コホート研究| 不整脈あり | 不整脈なし | 計 | |
|---|---|---|---|
| 曝露群 | 100 | 1900 | 2000 |
| 非曝露群 | 50 | 1950 | 2000 |
| 計 | 150 | 3850 | 4000 |
理解度チェック問題
無事卒業し医療専門職として羽ばたくために修学上のリスクを減らすためにどのようなことを心掛けたら良いか
第4回 研究法(2)量的研究(観察研究(2)介入研究),ROC解析
到達目標4-1リスクを求められなくても相対危険度を求めることができる
4-2観察研究と介入研究の違いについて説明できる
4-3感度や特異度など検査値と判定に関する指標について説明できる
教科書P13-25,P34-49,P73-74,P80,P100,P149-151
症例対照研究
症例群,対照群・・・過去に遡って追跡する集団観察の方向性では原因より結果が先行する・・・結果に基づく集団・・・疾病発生情報の妥当性が高い
・利点(短時間で行える 稀な疾患に対応できる)
・欠点(曝露に関する妥当性が低い)
相対危険度
なぜリスクを使わない?
取得したデータからリスクを求めることが出来ないから
例題4-1
なぜ,症例対照研究ではリスクを求めることが出来ないのか説明せよリスク比の代替
リスクを求められなくともリスク比と同等な相対危険度の指標をオッズ
事象の起こる確率と起こらない確率の比説明用データ
| 罹患有 | 罹患無 | 計 | |
|---|---|---|---|
| 曝露有 | A | B | A+B |
| 曝露無 | C | D | C+D |
| 計 | A+C | B+D |
暴露群の罹患オッズ=(A/(A+B))/(B/(A+B))=A/B
非暴露群の罹患オッズ=(C/(C+D))/(D/(C+D))=C/D
症例対照研究では(A/(A+B))が事象の起こる確率(=リスク)とはならないがオッズを算出する段階で頻度のみの関係になる
オッズ比
A/B/C/D=AD/BC<参考>一般的な説明
罹患有群の曝露オッズ(A/C)と罹患無し群の曝露オッズ(B/D)の比をとるのでAD/BC
例題4-2
玉入れ競争が終わったあとで,利き手でカゴに玉を入れる時と利き手じゃない方で玉を入れる時どれだけ失敗する確率が変わるのか調べることになった.そこでカゴに入っていた玉が185個あったのでそのうちの30個について入れた人30人がどちらの手で投げたのか調査した.
そして地面に落ちていた玉が15個あったので,15人全員にどちらの手で投げたのか調査したところ以下の結果になった.
利き手じゃないことによる相対危険度についてリスク比とオッズ比を算出し値を比較し,どちらを用いらた良いか考えを示せ
| 地面 | カゴ | 計 | |
|---|---|---|---|
| じゃない | 10 | 15 | 25 |
| 利き手 | 5 | 15 | 20 |
| 計 | 15 | 30 | 45 |
介入研究
実験研究ともいうコホート研究との違い
曝露を研究者がコントロールしない・・・コホート研究曝露を研究者がコントロールする・・・・介入研究
研究参加者に不利益が出ないように
ランダム化比較試験
交絡因子の影響(年齢,性別,職業,運動歴など・・・)を抑制できるランダム=無作為
被験者を群に無作為に割り当て・・無作為割付・・各群に被験者集団を反映した割付
システマティックレビュー
系統的総説と言われるもので複数の研究論文から結論を述べる論文メタアナリシス(それぞれの論文のデータを統合して分析する)が用いられるケースがある
資料
手良向 聡,臨床試験におけるランダム化の意義と限界,計量生物学41巻 1 号
https://www.jstage.jst.go.jp/article/jjb/41/1/41_37/_article/-char/ja/
盲検性の維持(製薬協)
https://www.jpma.or.jp/information/evaluation/results/allotment/2014tf6.html
ROC解析
検査法の診断的有用性を評価する話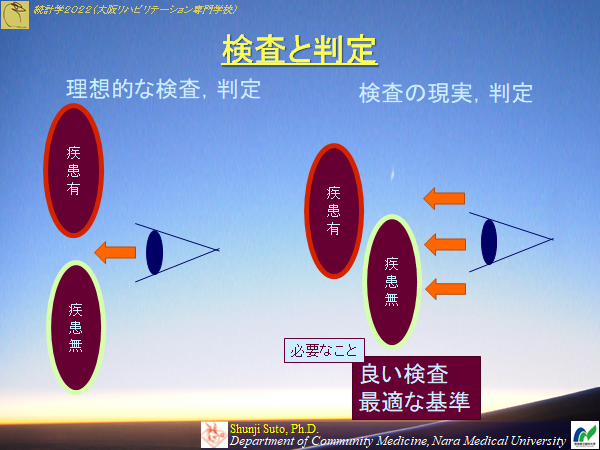
| 疾患あり | 疾患なし | 指標 | |
|---|---|---|---|
| 検査陽性 | 真陽性 a |
偽陽性 b |
陽性的中率 a/(a+b) |
| 検査陰性 | 偽陰性 c |
真陰性 d |
陰性的中率 d/(c+d) |
| 指標 | 感度 a/(a+c) |
特異度 d/(b+d) |
有病率 (a+c)/(a+b+c+d) |
予測値
有病率の影響を受ける陽性的中率=P(D|陽性)
陰性的中率=P(Dc|陰性)
感度と特異度
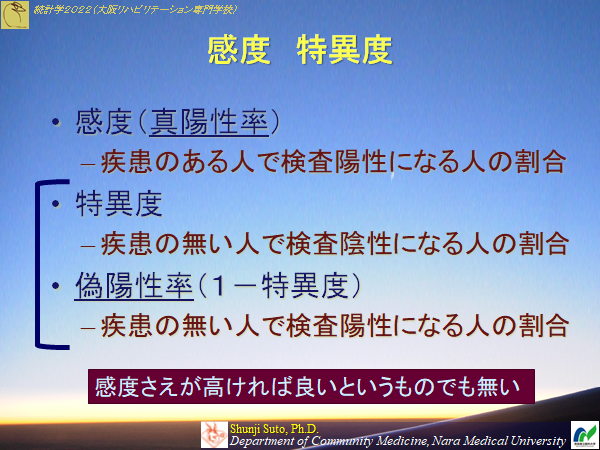
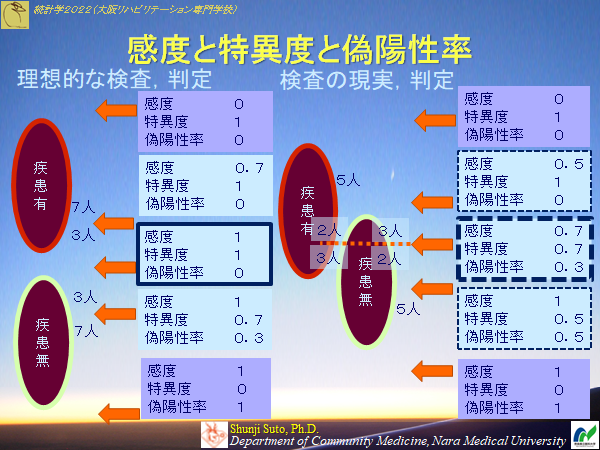
感度=P(陽性|D) 疾患群における真陽性の割合偽陽性率=P(陽性|Dc) 非疾患群における偽陽性の割合
特異度=1-偽陽性率 非疾患群における真陰性の割合
検査法の評価指標
AUC=ROC曲線を描いて算出 検査の分別能ROC曲線
判別度の分析感度と偽陽性率(1-特異度)を用いて曲線を描く
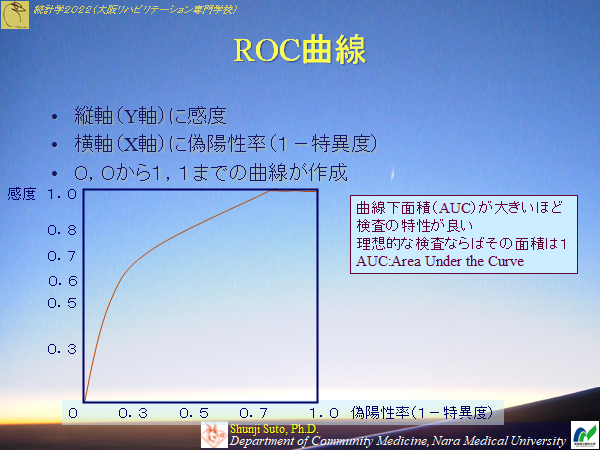
カーブが左上に行くほど検査特性が優れている.(=AUCが大きくなる)
判断基準は諸々の要素が入るが1,0と0,1の対角線と曲線の交わる部分が目安.あとは検査の目的などによって変わってくる
例題4-3
2種類の検査法A,Bを施行したところ以下の結果を得た.A法のROC曲線を描きAUCを求めよ
| 疾患群 | 14.3 | 15.2 | 13.8 | 14.1 | 13.9 | 12.6 | 14.2 | 14.6 | 13.1 | 13.7 |
| 非疾患群 | 13.2 | 14.1 | 13.8 | 13.6 | 12.9 | 12.4 | 12.1 | 12.3 | 12.3 | 12.8 |
| 疾患群 | 非疾患群 |
|---|---|
| 15.2 | |
| 14.6 | |
| 14.3 | |
| 14.2 | |
| 14.1 | 14.1 |
| 13.9 | |
| 13.8 | 13.8 |
| 13.7 | |
| 13.6 | |
| 13.2 | |
| 13.1 | |
| 12.9 | |
| 12.8 | |
| 12.6 | |
| 12.4 | |
| 12.3 | |
| 12.3 | |
| 12.1 |
理解度チェック問題
2種類の検査法A,Bを施行したところ以下の結果を得た.
B法のROC曲線を描きAUCを求めよ
AUCを求めどちらの検査が優れているか評価せよ
B法
| 疾患群 | 14.3 | 15.2 | 13.8 | 14.1 | 13.9 | 12.6 | 14.2 | 14.6 | 13.1 | 13.7 |
| 非疾患群 | 13.2 | 14.3 | 13.8 | 12.9 | 14.4 | 14.4 | 12.1 | 15.3 | 12.3 | 12.8 |
第5回 統計解析(3)推測統計(推定)
到達目標5-1記述統計と推測統計の違いについて説明できる
5-2なぜ標本より求めた平均をそのまま母平均の推定値として良いのか説明できる
5-3なぜ標本より求めた分散をそのまま母分散の推定値としたらいけないのか説明できる
5-4 母平均値の区間推定について100%の信頼区間を求めることに意味が無いことを説明できる
5-5 正規分布について説明できる
教科書P76-81
母集団と標本
母集団
対象としている集団の全体のこと無限母集団と有限母集団がある
標本
対象としている集団の一部偏ってしまうことに注意
例)森で取れた昆虫の標本を作成する際、どうしても森全体の昆虫の分布から偏ってしまう
標本という語の取り扱い
一般的に標本は物理的に存在するものを示すのですが,統計の世界ではデータを取り扱うので「標本」といいつつも物理的なものではなくデータを指しています.状況に応じて「標本集団」や「標本データ」(=標本)という言葉を使います
取り扱う標本について
母集団は20000人の収縮期血圧データ(整数)その集団の一部を抽出
母平均の推定
得られた標本より求めた平均をそのまま母集団の推定値とする例題5-1
以下の標本より平均値を求めよ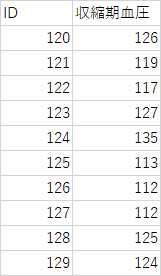
点推定
先程の例題で算出した値で母集団の特性値(母数)を推定すること推定で求められるのは偏った推定にならないこと.
(当然)標本が偏っていたら推定値は偏る
利点
計算が容易平均値の場合,計算式が母集団全体の値を求める時と標本から推定する時と同じで良い
欠点
必ずしも推定値が実際と一致するわけではない・・・むしろ外れて当然サンプルサイズ10の時(母集団から2000の標本が作成できる)のヒストグラム
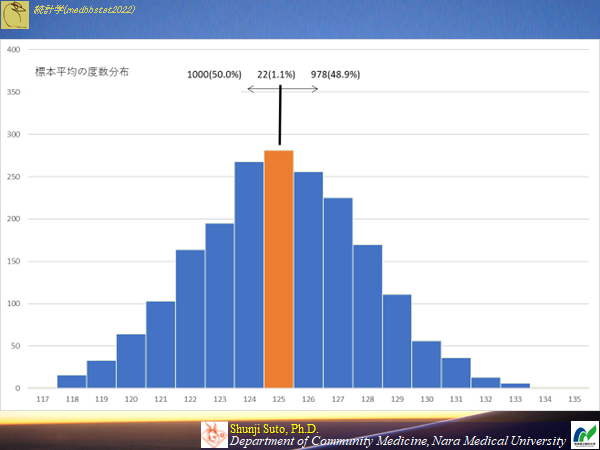
ピッタシ一致するのはサンプルサイズ10の時で1.1%(98.9%はハズレ)
推定の精度を上げるためには
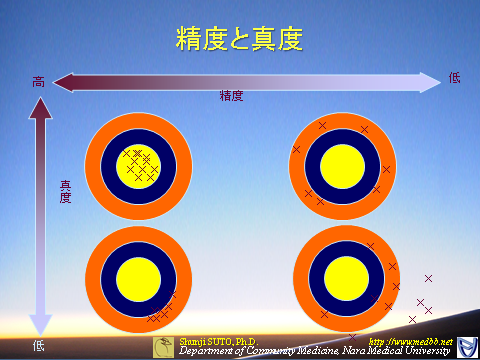
標本数を大きくすればよい・・・測定を繰り返して行いその平均をとると精度は上がる
サンプルサイズを100にした時の(母集団から200の標本が作成できる)のヒストグラム
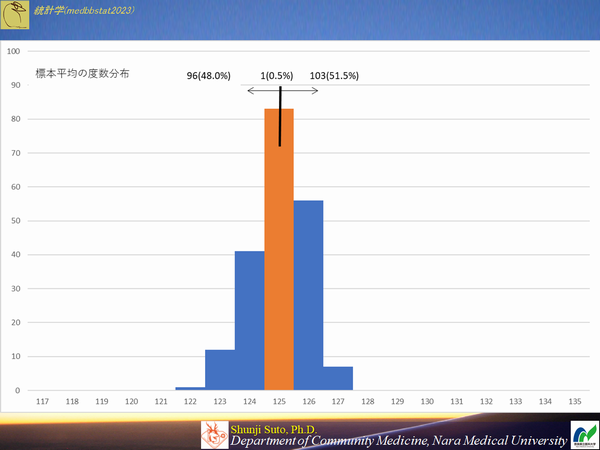
精度は上がるものの,ピッタシ一致する確率も上がるとは限らない
母分散の推定
例題5-2
以下の標本より標本の分散を求めよ点推定
先程の例題で算出した値では母集団の特性値(母数)の推定はできない推定で求められるのは偏った推定にならないこと.
(当然)標本が偏っていたら推定値は偏る
(注意)標本が偏っていなくても計算方法によって推定値が偏ることがある
標本の平均を用いサンプルサイズ10の時(母集団から2000の標本が作成できる)のヒストグラム
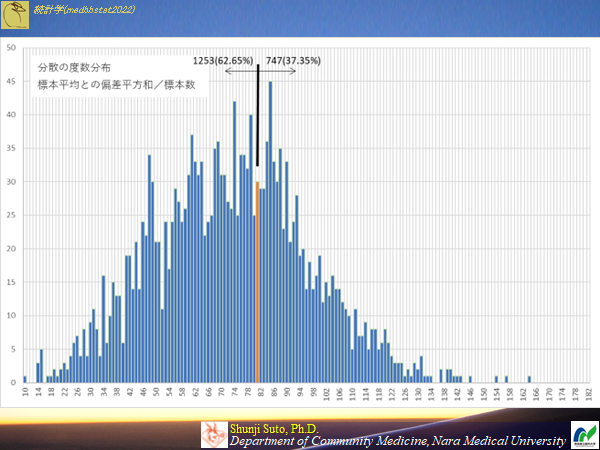
低めの値が多くなる傾向で偏っている.
母集団の平均(本来知る由もない)を用いサンプルサイズ10の時(母集団から2000の標本が作成できる)のヒストグラム
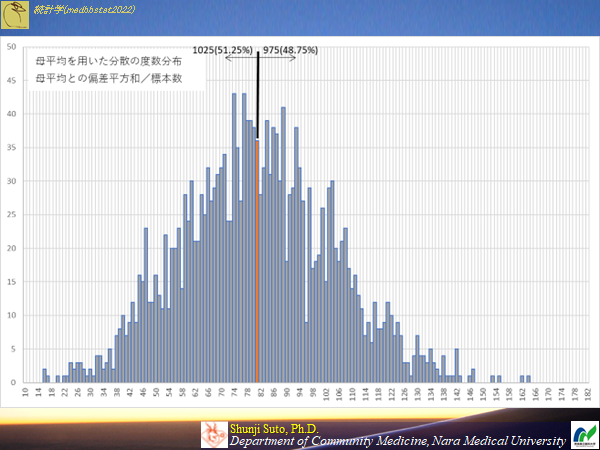
偏った推定にならないものの,本来知る由もない母平均を使えるわけがない(そもそも母数知っているなら推定は不要ですよね)
不偏分散
標本の平均を用いて母分散の推定を行う.母平均と標本平均は(ほぼ)異なるので,母平均と標本平均の差も考慮して分散を求めたもの
(無論母平均は分からないが母平均と標本平均の差を考慮している)
s^2=Σ(Xi-Xbar)^2/(n-1)
nで除するよりn-1で除したほうが,値が大きくなるのは当然なので,低めの値が出るのなら少し分母を小さくした方が大きくなるのは理解できるが(ケーキを3人で分けるのか4人で分けるのか)なぜ1引くだけ??となると思います
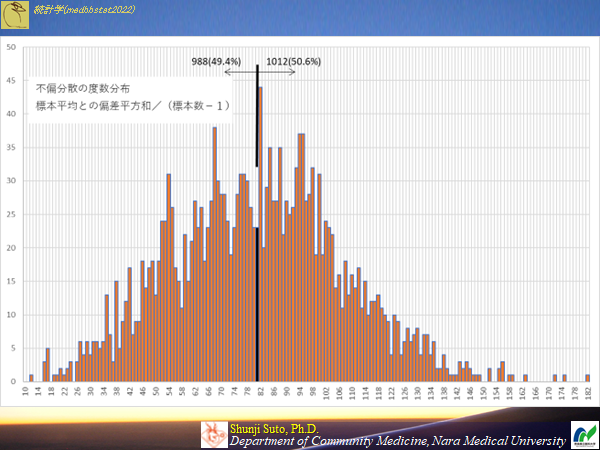
不偏分散は何故nではなく(n-1)で除するのか
求める対象(標本)が母集団全体だったとすると母分散は(1/n)Σ(xi-μ)2
しかしながら対象が母集団の一部であれば,母平均(μ)=標本平均(xbar)は期待できないので,μとxbarの差を考慮して母分散を求める(推定する)必要がある
(1/n)Σ((xi-μ) - (xbar-μ))2
=(1/n)Σ(xi-μ)2 - (2/n)Σ(xixbar - xiμ - μxbar + μ2) + (1/n)Σ(xbar-μ)2
=(1/n)Σ(xi-μ)2 - (2/n)Σ(xixbar) + (2/n)Σ(xiμ) + (2/n)Σ(μxbar) - (2/n)Σ(μ2) + (1/n)Σ(xbar-μ)2
=(1/n)Σ(xi-μ)2 - 2xbar2 + 2xbarμ + 2μxbar - 2μ2 + (xbar-μ)2
=(1/n)Σ(xi-μ)2 - 2(xbar2 - 2xbarμ + μ)2 + (xbar-μ)2
=(1/n)Σ(xi-μ)2 - 2(xbar - μ)2 + (xbar-μ)2
=(1/n)Σ(xi-μ)2 - (xbar - μ)2
-----
ここで それぞれ
(1/n)Σ(xi-μ)2=σ2
(xbar-μ)2
=((1/n)Σxi-μ)2
=((1/n)Σxi-(1/n)Σμ)2
=((1/n)Σxi-μ))2
=(1/n)2(Σ(xi-μ))2
=(1/n)(1/n)(Σ(xi-μ))2
=(1/n)σ2
=σ2/n
とおくと
-----
=σ2-σ2/n
=((n-1)/n)σ2
故に母分散の程よい推定値である不偏分散は
U=n/(n-1)・(1/n)Σ(xi-xbar)2
=(1/n-1)Σ(xi-xbar)2
となる.
例題5-3
以下の標本から母集団全体の分散および標準偏差を点推定せよ区間推定
点推定に幅をもたせたもの.幅の定義は確率(どの程度あたるものか)
∴100%あたる推定に意味は無い→確実に当たる幅を設定したら達成できるので
一般的に95%の確率で当たる区間(95%の信頼区間)で幅を決めている
平均値の区間推定
母平均の点推定値を中心に標本より求めた散布度(標準偏差)をベースにして±の幅を持たせる.問題点1
標準偏差をベースとは言うものの,サンプルサイズが大きくなると標本平均のバラツキは小さくなるという話があった・・・標本平均のバラツキ具合はサンプルサイズが大きくなると小さくなるという話.
サンプルサイズ10の時(母集団から2000の標本が作成できる)の標本平均のヒストグラム
サンプルサイズ100の時の(母集団から200の標本が作成できる)の標本平均のヒストグラム
標準誤差
・標準偏差は標本の分布のバラツキ具合を示したもの・標準誤差は母集団から抽出した標本の平均値のバラツキ具合
SE=σ/√n
(気になる方は)標準誤差SEはなぜ標準偏差σを√nで除したものになるのか
標準誤差は母平均に対する標本平均のバラつき指標(標準偏差)の話対象が母集団全体ならば0だが,母平均(μ)と標本平均(xbar)には差が生じる
ある標本における平均値と母平均の偏差平方は
(xbar-μ)2
=((1/n)Σxi-μ)2
=((1/n)Σxi-(1/n)Σμ)2
=((1/n)Σxi-μ))2
=(1/n)2(Σ(xi-μ))2
=(1/n)(1/n)(Σ(xi-μ))2
-----
ここで
(1/n)(Σ(xi-μ))2
をσ2とおくと
-----
=σ2/n
故に標準誤差は
SE=σ/√n
例題5-4
サンプルサイズ10の時の平均値(標本数2000)の標準偏差は2.83になります(平均値の標準偏差=標準誤差)それをサンプルサイズを100とした時の平均値の標準偏差(平均値の標準偏差=標準誤差)はどの程度の値になるでしょうか?
(ちなみにサンプルサイズ100の時の平均値(標本数200)を実際に求めたところ,不偏分散は0.84標準偏差は0.92になりました)
問題点2
点推定±標準誤差で区間を定めると,区間を推定していることになるが100%の確率で当たらない ということしかわからない.何%の確率で当たるのだろう?
中心極限定理(再掲)
標本の大きさが十分であれば標本平均の分布は正規分布→実験の時に複数回測定してその平均をとりましょう・・・・測定の精度が上がると言われた記憶 →測定回数を増やせば増やすほど
→正しく何回も測定されたのであれば偶然誤差の発生は正規分布に従う
誤差の話は二つの要因
正規分布
左右対称の釣鐘状分布平均値に近いほど出現率が高く遠ざかるに従って低くなる(ことが多い)
今更ながらだが,標本平均のヒストグラムって正規分布の形ですよね
標準正規分布
平均値が0標準偏差=1(分散も1)になるように値を変換したもの偏差値は平均値を50、標準偏差=10になるように値を変換したもの
標準正規分布表
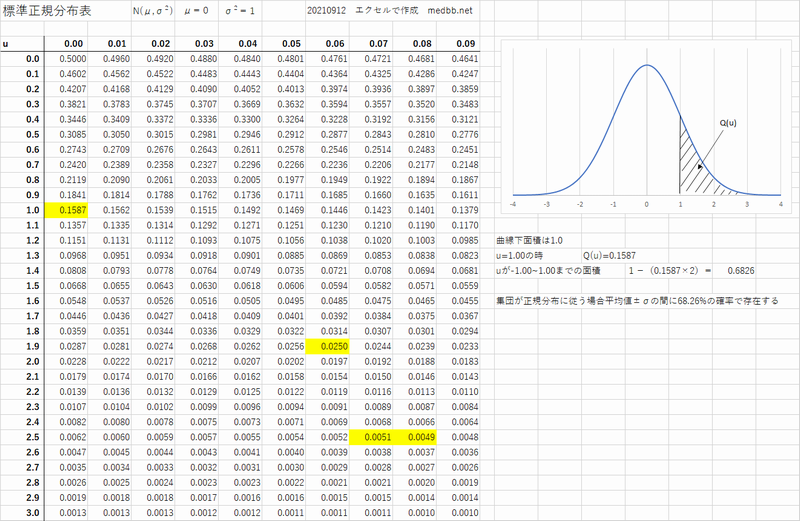
標準正規分布表のPDF版はコチラから
標準正規分布の世界は平均値が0標準偏差が1の世界→95%の確率で含まれる区間(信頼区間)は 0±(1×1.96) になります.
分布表から調べなくても1.96は見つけることが出来ます ← EXCEL[=NORM.S.INV(0.975)]
この関数は分布表と同じく上側の面積(=確率)を返してくれる変数ですので[=NORM.S.INV(1-0.025)]としたほうが解釈しやすいかなと思います.
例題5-4b
ある試験の受験者100人から点を教えてもらったところ平均値(点推定)=65点 標準偏差(点推定)=18点であった.受験全員(=母集団)の平均値の区間推定を信頼区間95%で示せ
t分布
母集団の平均値を推定するにおいて,標準正規分布を使うと上手くいかないケースがある・・・特に標本数が少ないと困っていたゴセットさんが標本数によって平均値の出現する確率が変化する分布を示しました.
諸々の理由でt分布と呼ばれています.
|
酒井 弘憲,ギネスビールと統計家ペンネーム スチューデント,ファルマシア51巻12号,2015 https://www.jstage.jst.go.jp/article/faruawpsj/51/12/51_1168/_article/-char/ja |
母集団の分散(標準偏差)が既知の場合(実際にはなかなかお見掛けすることは無いが),もしくはサンプルサイズが非常に大きく標本から求めたものの母集団の分散として取り扱って差し支えないものであれば正規分布で推定しても良い
t分布は標本より求めた母標準偏差の推定値(不偏分散に基づく標準偏差)を用いるが,標本の自由度(標本数より求める)によって変化する.
故に標本数が多くなるとt分布は正規分布に近似されていく.
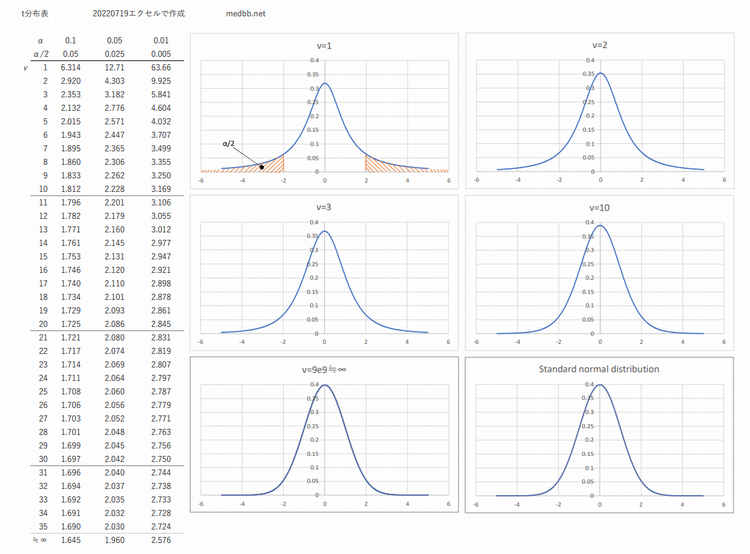
t分布のPDF版はコチラから
「自由度」νが出てきますが,以下考え方
標本の中で自由に振る舞うことが許されている値の数例えば標本から平均を求めたとき,その平均が母数の推定値としたら、自由に振る舞えない値が出てくる(つじつま合わせ)
t分布は抽出した標本数を基にしたものなので,正規分布のように一義的なものでは無く,標本数(自由度)によって確率分布が変わる
例題5-5
自由度が∞の時のt分布の95%信頼区間は正規分布と同じであるが自由度νが25の時,正規分布では何パーセント信頼区間に相当するのか?自由度が9の時も同様に求めよ
例題5-6
あるテストを受けた.受験者全員の平均点を推定したい.36名の受験者に協力してもらい点数を教えてもらった.36名の受験者の平均点は80点,偏差平方和を求めたところ15435になった.95%信頼区間で受験者全員の平均を標準正規分布とt分布でそれぞれ推定しどちらの区間幅が大きくなるか確認せよ.
理解度チェック問題
標準偏差は何のバラツキを示していて標準誤差は何のバラツキを示しているのか.両者の関係も含めて示せ
第6回 統計解析(4)推測統計(検定(1))
到達目標6-1仮説検定を行う理由について説明できる
6-2仮説検定の手順について説明できる
教科書P106-108
研究で得られた知見は常に正しいの?
研究で得られた知見が必ずしも正しいとは限らない少なくともその知見が妥当なものであることを示さなくてはいけない
その一つに量的なデータを取り扱う場合は統計的な手法によるものがある
科学
科学が,それ以外の文化と区別される基本的な条件としては,実証性,再現性,客観性などが考えられる。実証性とは,考えられた仮説が観察,実験などによって検討することができるという条件である。
再現性とは,仮説を観察,実験などを通して実証するとき,人や時間や場所を変えて複数回行っても同一の実験条件下では,同一の結果が得られるという条件である。
客観性とは,実証性や再現性という条件を満足することにより,多くの人々によって承認され,公認されるという条件である。
<引用>
小学校学習指導要領解説(文部科学省)
https://www.mext.go.jp/a_menu/shotou/new-cs/1387014.htm
【理科編】小学校学習指導要領(平成29年告示)解説(文部科学省)
https://www.mext.go.jp/content/20211020-mxt_kyoiku02-100002607_05.pdf
世の中には未だ(これからも)科学的に証明されていないものは存在する
生活者の視点だと流通している食材は安心安全な食材で科学的に検証されている(=故に科学は正しい)と捉えてしまうように思います.「フグの卵巣」は科学的に証明されていない手法で,安心安全な食材として流通しています
一般的に技術=科学技術と置き換えてしまっているように思いますが,科学で説明できない技術に基づくものは社会に存在します.
当然ながらその技術も正しく使わなければ安全な食材にはなりません
世の中全てを科学で語ることができたならば,それはより良い未来に繋がるだろうと思いますが,世の中そんなに甘くないというところですかね
<参考>
世界の珍食一位猛毒「フグの卵巣の糠漬け」(東京新潟県人会)
https://kouhou.niigatakenjinkai.com/?p=2835
COREZOコレゾ「自分に抱え込もうとすると、水は溢れ出し、外に押し出せば、水は自分のところに流れ込んでくると、郷土の伝統食品、ふぐ卵巣ぬか漬を守り続ける七代目」賞(一般財団法人コレゾ財団)
https://corezoprize.com/araki-toshiaki
No.19001 フグ(卵巣)による食中毒(H-CRISIS 国立保健医療科学院)
https://h-crisis.niph.go.jp/archives/136651/
1.実証性
「考えられた仮説」が無いことには始まらない→仮説検証型それでは「考えられていない仮説」とは?
→まだ十分に確固たる仮説として成立していない仮説
仮説検証型と仮説探索型
仮説探索型とは「考えられた仮説」が存在せず(興味深い事象ではあるものの),得られた結果は「考えられた仮説」になりうるレベルで「まだ考えられたものと言い切れない仮説」経営の世界は統計処理によって出てきた結果よりアイデアを膨らます
2.再現性
仮説を実証するために得られたデータから複数回,同一の検証結果になること「常に」同一の検証結果になることを求めていないが,それは求められないから
再現性の限界
再現性の条件は「仮説の実証を複数回行っても同一の結果が得られる」ことですが,その回数が無限であるならばその条件は永遠に満たされません.故に有限となりますが,それはある回数(x回)まで同一の結果としても,x+1回目以降同一の結果にならない可能性を含んだものになります.
これは未来において,その仮説が覆される可能性があることを示すもので,反証可能性といわれるものです.
再現性の限界を超える方法
「仮説の実証を∞回行っても同一の結果が得られる」実証で得られたデータについてどのようなものであっても同一な結果が出るように判定基準を定める
EBM
Evidence-Based Medicine根拠に基づいた医療
「根拠」・・・科学的根拠と表現されているケースも多い(経験則のみに基づかないようにという意味合いを込めてというところかな)
科学的根拠
根拠にもグレードがあるまた,医療提供においては「科学に基づく根拠」以外の要因(価値観,資源)も含めて判断しなくてはならない
参考
エビデンスから推奨を作成するために GRADEシステムの発展に向けて(THERAPEUTIC RESEARCH On-line)
https://therres.jp/3topics/2011/20110525165004.php
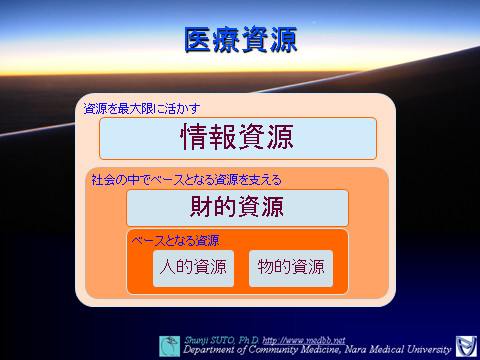
(不足の観点からみる医療2.0β より)
「根拠に基づく医療」(EBM)を理解しよう(厚生労働省eJIM(イージム「統合医療」情報発信サイト))
https://www.ejim.mhlw.go.jp/public/hint2/c03.html
特集:EBMとEBH『公衆衛生研究』 第49巻 第4号 (2000年12月)
https://www.niph.go.jp/journal/data-49-4-j49-4/
仮説検定
仮説検定はなぜ必要なのだろうか?
その仮説が科学に基づいたものであることを統計手法を用いて証明したいから例題6-1
科学的に証明されたものは100%正しいと言ってよいのだろうか?検定(有意差検定)と推定の違い
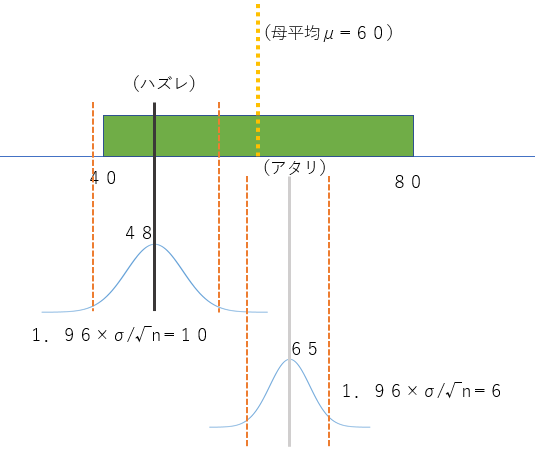
推定
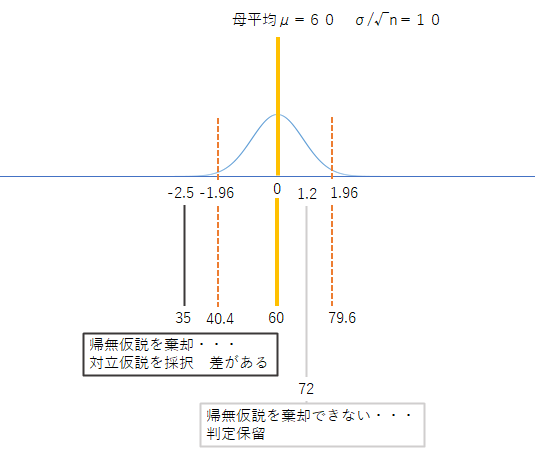
検定
例題6-2
再現性は本来「未来永劫」だと思うが,なぜ「複数回」同一の検証結果になることとしているのか判定基準
「同一の結果」が100%の確率で出現しないことを示しておく必要が出てくる→そうなると,確率に基づく基準で判定しないことには,再現性を満たすことが出来ない
故に仮説検定は確率に基づいて行う
「確率」⇔「実空間での違い」
区間推定では,ある確率分布による確率(例えば95%)を統計指標(標準正規分布ならz値)に置き換えてから,実空間での対象とする事柄に置き換えて信頼区間を求めている仮説検定では,実空間で対象とする事柄の違いを求めてから,確率分布における統計指標に置き換えて確率を求めている
区間推定と仮説検定の相反する部分
区間推定は区間内に求めているものがある(含まれている ことを祈っている)仮説検定は区間外に求めているものがある(含まれていないことを祈っている)
背理法
命題の否定を仮定して話をすすめて、その矛盾を示すことで命題が成り立つとする論法違いがあることを証明するにあたって「違いが無いことを」を証明できないことを根拠にする
仮説検定を背理法に基づいて行う理由
仮説検定を行う動機は,これまでの世界の科学的な常識とは異なる新たな知見を証明することにある
これまでの常識は繰り返し用いられてきた.
新たな知見はこれまでの常識を科学的に否定しなくてはならない
つまり,従来の手技,薬剤と同じように新しい手技,薬剤を用いた時に再現性がみられなかったら,それは従来の常識を覆すものであると判定して証明する論法
なので背理法に似ているが,得られたデータから矛盾を論理的に説明できないので,得られたデータより確率的に起こらない事象が起きたか否かで判断する
統計的有意差と臨床的有意差
得られたデータに基づき計算した確率が判定基準を下回った時に統計的有意差があると言います.
知見は社会実装することで人類に貢献できますが,医療現場においては臨床的に意味があるとされる量を基準とする臨床的有意差が結果として求められます
無論社会で役立てていく知見としては,統計的有意差よりも臨床的有意差が重要になりますが,「科学的」な観点からは前者が支配的になります.
確率の違いを量で示すとき,その量はサンプルサイズにより変化します.故に臨床的有意差に基づきサンプルサイズを決定することで二つの違いを解消できます
例えば臨床的有意差が統計的有意差よりも大きい場合は再現性については確認できたものの臨床的な観点から確認はできません.統計科学的に良いが,医科学的には?という結果になります
一般にはサンプルサイズが大きいほど,精度の高い結果が得られるので良いという感覚のはすですが,それは区間推定の話で仮説検定において効果量の差を検証する場合は少し状況が異なります
両側検定と片側検定の注意点
両側検定は両方向に棄却域を設ける → 平均値の区間推定と同じ考え方
片側検定は片方向のみ棄却域を設ける→ 同じ有意水準の場合,棄却域が大きくなるのでそのままは推奨しない

一緒な有意水準で比較した場合 片側は棄却域が存在しないことと,他方は棄却域が大きくなってしまう → 帰無仮説が棄却されやすくなる状況
あえて片側検定を行う場合は有意水準について考慮が必要
仮説検定の流れ
1)手順1 帰無仮説,対立仮説をたてる
帰無仮説は違いが無い仮説(これまでと同じ結果) 対立仮説はこれまでの常識を覆す仮説
これまでの介入では見られなかった効果が,新しい介入では見られたことを統計的に明らかにする話
帰無仮説H0:μ=150 対立仮説H1:μ≠150
手順2 母集団が従うと見做す確率分布を定め,有意水準を決める
正規分布に従うと見做し,有意水準両側5%とする
手順3 今回取得したデータをもとに,母集団が従うと見做す確率分布における統計量を求める
-2.7異なる,これを(標準正規分布の)検定統計量に変換すると-1.8
手順4
検定統計量を用いて有意水準との比較,今回の標本が棄却域にあるのか否か(受容域なのか)判定する.
1)(ケースX)
|z|=( ) p=( )×2(両側検定なので2倍)が有意水準(5%=0.05)よりも低い確率か高い確率か高い確率( )帰無仮説を棄却できないので判定を保留する
低い確率( )帰無仮説を棄却し対立仮説を採択する 有意差がある
注)正規分布の場合標準正規分布表を用いて確率を求めて比較可能だが,t分布表は統計量の確率を求められないので有意水準の確率に相当する統計量を用いて比較する
理解度チェック問題
検定では一般的に5%を基準とする場合が多いが,自分で基準を決めるならば何パーセントにしますか?理由も添えて
第7回 統計解析(5)推測統計(検定(2))
到達目標7-1二標本(関連2群)t検定(差の平均値の検定)の概要を理解できる
7-2求めた検定統計量から判定できる
教科書P76-81
二標本(関連2群)t検定(差の平均値の検定)

二つの標本データは同じ標本集団から取得したケースでのみ用いることが出来ます
paired-t検定とよばれるケースが多いです.本によっては二標本と書いたり,標本については表記しなかったりです
同一被験者に介入前後で2回データを取るので標本は二つだが一つの標本集団から取得しているので関連2群とよばれます
介入の効果が無ければ前後の差を計算すると0が期待されるので0なのか否なのかの判断になります.
二標本(関連2群)t検定の計算の流れ
1)それぞれの標本の差を求める2)それぞれの標本の差の平均を求める
3)それぞれの標本の差の不偏分散を求める→標準誤差を求める
4)想定する母平均と標本の差の平均との差をt値に変換する
5)t値をt分布を用いて有意水準と比較をする
例題7-1
新開発のシューズEを開発した.それぞれ同一被験者に従来型と新型を履いて5km走のタイムを計測し比較を行った.有意水準5%両側検定を行い効果があるのか検証せよ


回答
新開発ランニングシューズと普段のランニングシューズのタイム差をID毎に求め,平均を求める| ID | タイム差 |
|---|---|
| 1 | |
| 2 | |
| 3 | |
| 4 | |
| 5 | |
| 6 | |
| 7 | |
| 8 | |
| 9 | |
| 10 | |
| 平均(標本の群間の差の平均値(母平均の推定値)) | |
| 標準偏差(母標準偏差の推定値) |
母集団の平均値=( )
標本の群間の差の平均値 = ( )
母集団の平均値と標本の平均値の差 = ( )
標準誤差=( )
t値=標本の群間の差の平均値/標準誤差=( )
t分布表より両側検定で有意水準両側5%の時のt値は( )
( )帰無仮説を棄却できないので判定を保留する
( )帰無仮説を棄却し対立仮説を採択する 有意差がある
理解度チェック問題
新開発のシューズFを開発した.それぞれ同一被験者に従来型と新型を履いて5km走のタイムを計測し比較を行った.
有意水準5%両側検定を行い効果があるのか検証せよ(回答は下記の計算をした上で「帰無仮説を棄却できないので判定を保留する」「帰無仮説を棄却し対立仮説を採択する 有意差がある」のいずれかを示してください

回答
新開発ランニングシューズと普段のランニングシューズのタイム差をID毎に求め,平均を求める
| ID | タイム差 |
|---|---|
| 1 | |
| 2 | |
| 3 | |
| 4 | |
| 5 | |
| 6 | |
| 7 | |
| 8 | |
| 9 | |
| 10 | |
| 平均(標本の群間の差の平均値(母平均の推定値)) | |
| 標準偏差(母標準偏差の推定値) |
母集団の平均値=( )
標本の群間の差の平均値 = ( )
母集団の平均値と標本の平均値の差 = ( )
標準誤差=( )
t値=標本の群間の差の平均値/標準誤差=( )
t分布表より両側検定で有意水準両側5%の時のt値は( )
( )帰無仮説を棄却できないので判定を保留する
( )帰無仮説を棄却し対立仮説を採択する 有意差がある
第8回 統計解析(6)推測統計(検定(3))
到達目標8-1二標本(独立2群)t検定(平均値の差の検定)の概要を理解できる
8-2二標本(関連2群)t検定(差の平均値の検定)との違いを説明できる
8-3求めた検定統計量から判定できる
教科書P76-81
二標本(独立2群)t検定とよばれます
効果が無ければ前後の差を計算すると0が期待されるので0なのか否なのかの判断になります.
それぞれの標本は異なる標本集団から標本データを取得したケースでも用いることが出来ます
差の平均値の検定(関連2群)と平均値の差の検定(独立2群)の相違点
【同じ】平均値
差の平均値(関連2群)と平均値の差(独立2群)は同じ例題7-1(関連2群)のデータよりそれぞれ求めると

【異なる】標準誤差
差の平均値(関連2群)の検定の場合
二つの標本の差を用いて分散・標準偏差を算出 → 標準誤差例題7-1(関連2群)のデータより求めると

差の不偏分散=0.136 差の不偏分散より求めた標準偏差=0.369 標準誤差=0.117
平均値の差(独立2群)の検定の場合
それぞれの標本から分散・標準偏差を算出し合成 → 標準誤差例題7-1(関連2群)のデータを独立2群と見做して合成分散を求めると

普段シューズの不偏分散=0.218 新シューズEの不偏分散=0.238
合成分散=(0.218×9+0.238×9)/18=0.228
合成分散より求めた標準偏差=0.477 標準誤差=0.151
分散・標準偏差の合成
重みづけ平均を求める例題8-1
100本のおみくじにはアタリが30%の確率で入っています.200本のおみくじにはアタリが7.5%の確率で入っています.
二つのおみくじを混ぜたときアタリの確率は何%になりますか?
回答
100本のおみくじに入っているアタリくじの枚数=100×0.3=30
200本のおみくじに入っているアタリくじの枚数=200×0.075=15
アタリくじの合計枚数=30+15=45
おみくじの合計枚数 =100+200=300
二つのおみくじのアタリの合成確率は 45/300=0.15
例題8-2
標本Aは標本数が11で不偏分散を求めたところ200だった.標本Bは標本数が21で不偏分散を求めたところ100だった.
合成した不偏分散およびその標準偏差を求めよ 回答
標本Aの偏差平方和=( )=( )
標本Bの偏差平方和=( )=( )
標本AとBの偏差平方和の合計=( )=( )
不偏分散を求める際の分母(=標本数-1)の合計=( )=( )
標本A,B二つの不偏分散の合成分散=( )=( )
二標本(独立2群)t検定の計算の流れ
1)それぞれの標本の平均を求める2)それぞれの標本の不偏分散を求める
3)それぞれの標本の不偏分散を合成し標準偏差→標準誤差を求める
4)想定する母平均と標本平均の差をt値に変換する
5)t値をt分布を用いて有意水準と比較をする
例題8-3
A組とB組(ともに16名にある単元の授業を行い効果を確認するために試験を行ったA組には従来どおりの教員による授業を,B組にはAIロボットのみによる授業を行った.
仮説はAIロボットによる授業より従来の授業の方が高い学修効果につながる というところです
テストの結果は以下のとおりです
 回答
帰無仮説H0:μ1=( )対立仮説H1:μ1≠( )
二つの母集団の平均値の差 μ1-μ2=( )
標本の平均値の群間の差 = ( )
母集団の平均値の差と標本の平均値の群間の差 = ( )
二つの標本を合成した標準誤差=( )
t値=標本の群間の差の平均値/標準誤差=( )
t分布表より両側検定で有意水準両側5%の時のt値は( )
( )帰無仮説を棄却できないので判定を保留する
( )帰無仮説を棄却し対立仮説を採択する 有意差がある
例題8-4
AA組とBB組(ともに16名)にある単元の授業を行い効果を確認するために試験を行ったAA組には従来どおりの教員の授業にAIロボットと役割分担したもの,B組にはAIロボットのみによる授業を行った.
仮説はAIロボットによる授業より従来の授業にAIロボットの強みを活かすことでAIロボット単体よりもより高い学修効果につながる というところです
テストの結果は以下のとおりです
 回答
帰無仮説H0:μ1=( )対立仮説H1:μ1≠( )
二つの母集団の平均値の差 μ1-μ2=( )
標本の平均値の群間の差 = ( )
母集団の平均値の差と標本の平均値の群間の差 = ( )
二つの標本を合成した標準誤差=( )
t値=標本の群間の差の平均値/標準誤差=( )
t分布表より両側検定で有意水準両側5%の時のt値は( )
( )帰無仮説を棄却できないので判定を保留する
( )帰無仮説を棄却し対立仮説を採択する 有意差がある
差の平均値の検定(関連2群)と平均値の差の検定(独立2群)の使い分け
利用条件
(制限が多い)差の平均値の検定(関連2群)
(制限が無い)平均値の差の検定(独立2群)
どちらも使える場合は
目的をある介入による効果のみを見る場合は,関連2群は標本それぞれで生じた差のみ取り扱うことができる.
そのデータを独立2群で行った場合,生じた差だけではなく標本それぞれ固有の値が異なることも含めた評価になる.
ある介入前後のデータを取得する場合は,介入による差について調べたいケースと思うので関連2群が良いと思います
「【異なる】標準誤差」の標準誤差の結果を比較してください
例題8-5
「【異なる】標準誤差」の標準誤差の結果は独立2群の検定で求めた標準誤差の方が関連2群のものよりも大きい値となった
関連2群 標準誤差=0.117
独立2群 標準誤差=0.151
関連2群で求めた標準誤差(介入前後の差分より求めた不偏分散を用いた)と独立2群で求めた標準誤差(介入前の不偏分散と介入後の不偏分散を合成して用いた)の関係を選べ
回答
( )常に関連2群の標準誤差≧独立2群の標準誤差の関係が成立する
( )常に独立2群の標準誤差≧関連2群の標準誤差の関係が成立する
( )介入により異なる
どちらも使えない場合は
標本数が少なすぎるなど,平均値の検定が使えないケースは存在します
例題8-6
関連2群の制限に関する文章の空欄に適切な語を入れよ
回答
1)差の平均値の検定(関連2群)を行うには,2群のデータ数は同じ( )
(選択肢 A:である必要は無い B:であることが望ましい C:でなければならない)
2)差の平均値の検定(関連2群)を行うには,2群のデータの測定対象者は全て同じ( )
(選択肢 A:である必要は無い B:であることが望ましい C:でなければならない)
差の平均値の検定(関連2群)の制限事項
同じ対象に2回データを取得しなくてはならない・・・取れないケースは多い
前回の例題(ランニングシューズ)は100m走なのでシューズを履き替えて再度測定して問題無かったが,長距離用のシューズだと・・・
二標本(独立2群)t検定(平均値の差の検定)は二つの方法があります
ここではスチューデントのt検定を行いましたが,もう一つウェルチのt検定もあります.
スチューデントのt検定は標本の分散は同等(同じ母集団から抽出した標本だから)が前提なので,合成する際に値が極端に偏ると扱えない欠点がありました
昔の教科書は等分散であればスチューデントのt検定,そうじゃなければ(=非等分散)ウェルチのt検定 と記載されていましたが,条件にかかわらずウェルチのt検定を支持する方が増えてきました
近年はスチューデントのt検定をバージョンアップ(計算が少しややこしい)したウェルチのt検定を等分散,非等分散に関わらず使うべきというのが主流になりつつあります
ちなみにエクセルはどちらにも対応して一つの関数で検定の計算は完成します

理解度チェック問題
以下の内容を検定する場合どの手法が良いか選べ
1)統計学受講者16名に対する講義前テストと講義後テストの点の比較
2)本学の統計学受講者20名と他学の統計学受講者20名に共通のテストを行った点の比較
3)作業者21名が静かな空間で仕事を行った時と騒音のある部屋の時のそれぞれの作業量(製作数)の比較
選択肢:
A:二標本(関連2群)t検定(差の平均値の検定) B:二標本(独立2群)t検定(平均値の差の検定)
回答
1) 2) 3)
参考資料
全国学生調査(文部科学省)
https://www.mext.go.jp/a_menu/koutou/chousa/1421136.htm
以下の内容を検定する場合どの手法が良いか選べ
1)統計学受講者16名に対する講義前テストと講義後テストの点の比較
2)本学の統計学受講者20名と他学の統計学受講者20名に共通のテストを行った点の比較
3)作業者21名が静かな空間で仕事を行った時と騒音のある部屋の時のそれぞれの作業量(製作数)の比較
選択肢:
A:二標本(関連2群)t検定(差の平均値の検定) B:二標本(独立2群)t検定(平均値の差の検定)
回答
1) 2) 3)
全国学生調査(文部科学省)
https://www.mext.go.jp/a_menu/koutou/chousa/1421136.htm